Pour extraire le texte d'une image haute résolution, un modèle d'IA coûte de 10 à 20 fois plus cher qu'un outil traditionnel de reconnaissance optique de caractères (OCR, pour Optical Character Recognition). Sur papier, le choix est vite fait. Mais en développant une application de rapport de caisse pour le commerce de détail, nous avons constaté que le prix à l'image n'est pas la bonne mesure. La bonne mesure, c'est ce qu'il en coûte d'obtenir la bonne donnée, dans les conditions réelles.
L'OCR lit des caractères, pas des documents
L'OCR transforme des pixels en lettres, et il le fait bien. Donnez-lui une page numérisée, droite, bien éclairée, sur fond blanc, et le texte ressort presque parfait.
Mais un rapport de caisse n'a pas besoin de texte. Il a besoin de données : le commerçant, la date, le sous-total, les taxes, le total, le mode de paiement. Or l'OCR ne sait pas lequel des douze montants imprimés est le total. Il renvoie des mots et leurs coordonnées ; c'est à vous de reconstruire le sens à partir de la position. « Le montant à droite du mot TOTAL, sur la même ligne. » Tant que la ligne est droite, ça fonctionne.
Le reçu parfait n'existe pas
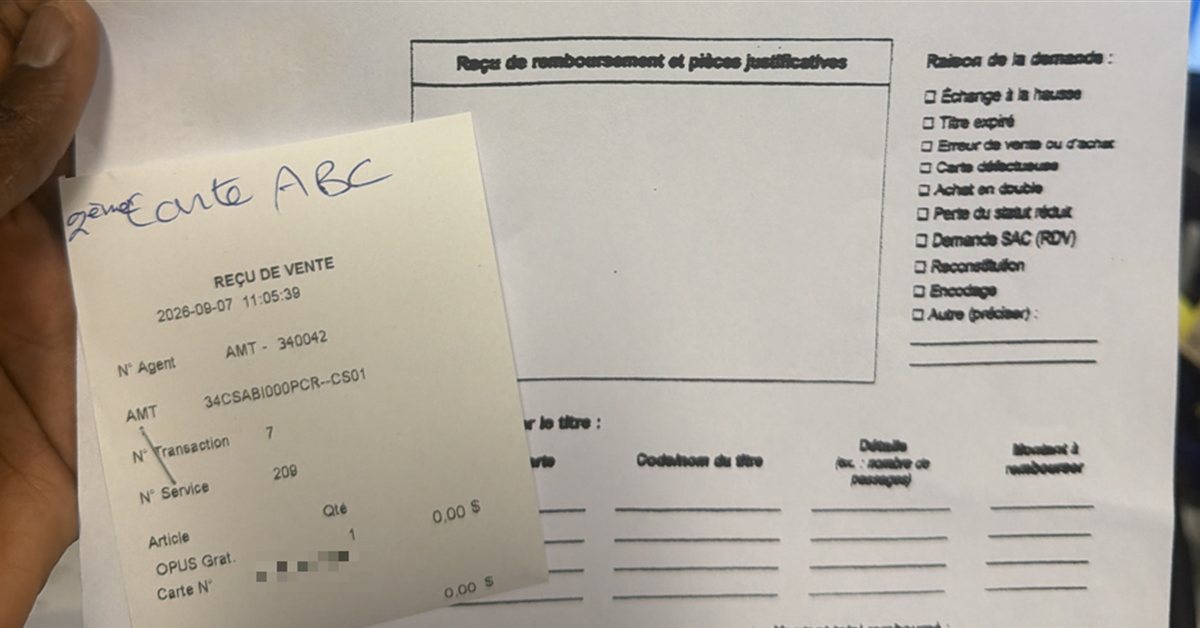
Les reçus d'un rapport de caisse ne passent pas par un numériseur de bureau. Ils sont photographiés au téléphone, en fin de quart, souvent entre deux tâches. Chaque photo arrive avec ses difficultés, et chacune casse le raisonnement spatial dont l'OCR dépend.
- Le positionnement. Le reçu n'est pas centré : il occupe un coin de l'image, ou il déborde du cadre. Avant de le lire, il faut le trouver.
- L'angle. La photo est prise de biais, et la perspective déforme le reçu. « La même ligne » ne veut plus rien dire : le montant à droite de TOTAL se retrouve à la hauteur de la TVQ.
- L'arrière-plan. Un comptoir, un tapis de caisse imprimé, un autre papier dessous. L'OCR y voit des caractères, ou confond les bords du reçu avec le décor.
- Le papier lui-même. Le papier thermique est froissé, plié, pâli. Les ombres et les reflets font le reste.
Chaque problème a une solution technique connue : détection des contours, redressement, correction de perspective, suppression du fond. Mais chacune est une étape de traitement à écrire, à calibrer et à maintenir, avec ses cas limites qu'on découvre au contact de la réalité.
Trois reçus sur la même photo
Puis vient le cas le plus difficile. Pour gagner du temps, l'employé aligne trois reçus sur le comptoir et prend une seule photo. C'est parfaitement raisonnable.
Pour l'OCR, c'est un casse-tête. Il lit de gauche à droite, et les lignes des reçus voisins s'entremêlent : le commerçant du premier, la date du deuxième, le total du troisième. Il faut d'abord segmenter l'image — détecter chaque reçu, le découper, le redresser — avant même de commencer à lire. Quand deux reçus se touchent, même cette étape devient incertaine.
On peut interdire la pratique, bien sûr. Mais une consigne qui va à l'encontre d'un geste naturel ne sera pas suivie. C'est à l'outil de s'adapter à la façon dont les gens travaillent, pas l'inverse.
Ce que l'IA fait différemment
Un modèle de vision ne reconstruit pas un document à partir de caractères isolés. Il regarde l'image entière et comprend ce qu'elle contient : trois reçus, sur un comptoir, légèrement en angle. Il ignore le décor. Il sait qu'un total se trouve généralement en bas, après les taxes, et qu'il ne se confond pas avec le montant remis ou la monnaie rendue.
Surtout, on ne lui demande pas du texte : on lui demande une structure, soit une liste de reçus avec, pour chacun, les champs dont le rapport a besoin. Le positionnement, l'angle, l'arrière-plan et la séparation des reçus ne sont plus des étapes à programmer ; le modèle les absorbe.
L'écart de développement est considérable. D'un côté, une chaîne de traitement d'image et des règles de positionnement qui grossissent à chaque nouveau format de reçu. De l'autre, une définition claire des données attendues et des règles de validation. Le second se construit en jours plutôt qu'en semaines, et ne s'effondre pas quand un fournisseur change le gabarit de ses factures.
Et le prix, alors ?
De 10 à 20 fois plus cher par image, ça reste vrai. Mais il faut le mettre en perspective : l'IA règle des problèmes de vision par ordinateur que les approches traditionnelles peinent à résoudre. À quelques centaines de reçus par jour, l'écart de coût reste faible comparé au temps qu'une personne passerait à corriger une saisie ratée.
Les contextes qui favorisent l'IA
L'IA n'est pas toujours le bon choix, mais elle l'est clairement quand plusieurs de ces conditions sont réunies :
- Vous ne contrôlez pas la capture. Les images viennent de téléphones, d'employés ou de clients, avec un éclairage et un cadrage que personne ne standardise.
- La mise en page varie. Des dizaines de commerçants, de terminaux et de fournisseurs, chacun avec son propre gabarit.
- Une image peut contenir plusieurs documents. Reçus côte à côte, pages superposées, bordereau agrafé à une facture.
- Vous avez besoin du sens, pas du texte. Distinguer le total du sous-total, reconnaître une taxe, associer un montant à son mode de paiement.
- Le volume est modéré. Des centaines ou des milliers de documents par jour, où l'écart de prix reste marginal face au traitement manuel.
- Le temps de développement compte. Vous voulez une solution rapidement en production, sans équipe dédiée pour la maintenir.
Quand l'OCR reste le bon outil
À l'inverse, l'OCR traditionnel garde tout son sens quand vous contrôlez la source : un numériseur fixe, un format de document unique et stable, des volumes qui se comptent en millions de pages, ou un simple besoin de texte brut pour l'archivage. Il reste aussi une option solide lorsque les documents ne peuvent pas quitter vos serveurs.
Les deux approches peuvent d'ailleurs cohabiter : l'OCR pour les documents propres et prévisibles, l'IA pour ceux qui échouent à la validation. C'est ce que nous avons mis en place pour notre client.
Faire confiance, mais vérifier
Un reçu a un avantage rare : il se vérifie lui-même. Le sous-total plus les taxes doit donner le total ; la TPS et la TVQ doivent correspondre aux taux en vigueur ; la date doit tomber dans la période du rapport. Ces contrôles simples attrapent la grande majorité des erreurs de lecture, et renvoient le reçu douteux à un humain au lieu de fausser la caisse.
Là où aucune vérification de ce type n'est possible, on peut faire lire le document par deux IA différentes. Dans tous les cas, le principe est le même : l'IA ne remplace pas le contrôle, elle remplace la saisie.
Vous avez des reçus, des factures ou des bordereaux qui finissent en saisie manuelle, et un OCR qui n'y arrive pas ? Regardons ensemble ce qui fonctionnerait chez vous. Parlons-en.
— Frédéric Brabant